Ôn Tập ii: Từ biến ngẫu nhiên tới đo lường rủi ro danh mục đầu tư
Khám phá cách sử dụng biến ngẫu nhiên, kỳ vọng và ma trận hiệp phương sai để đo lường rủi ro danh mục đầu tư. Hướng dẫn tính toán thực tế trên Python/Excel với các cổ phiếu từ S&P 500.
Chào mừng bạn quay trở lại với series Ôn Tập. Trong thế giới của Quant, mọi thứ từ giá cổ phiếu, lợi suất cho đến rủi ro đều được coi như những biến ngẫu nhiên. Việc hiểu rõ bản chất của chúng từ kỳ vọng, phương sai, cho đến sự tương quan giữa các biến là vô cùng quan trọng.
Bài viết này cũng giới thiệu về lý thuyết quản lý danh mục đầu tư. Như câu thành ngữ “Đừng bỏ trứng vào cùng một giỏ”, chúng ta sẽ cùng giải mã tại sao việc chia trứng lại có thể giúp bạn ngủ ngon hơn giữa những biến động của thị trường.
Lưu ý: Nếu bạn đã quá quen thuộc với các khái niệm xác suất thống kê cơ bản, bạn hoàn toàn có thể bỏ qua.
Trong bài viết này:
- 1. Biến ngẫu nhiên trong tài chính
- 2. Các đặc trưng của biến ngẫu nhiên
- 3. Ứng dụng trong quản lý danh mục đầu tư
- 4. Tóm tắt và thảo luận
- Appendix
1. Biến ngẫu nhiên trong tài chính
Biến ngẫu nhiên (random variable) là một biến nhận giá trị dựa trên một quy luật xác suất nhất định – giống như chiếc hộp đen mỗi khi bạn lắc sẽ rơi ra một con số theo một quy luật may rủi nào đó, hay một con xúc xắc cho ra các giá trị từ 1 đến 6 với xác suất đồng nhất.
Trong thế giới tài chính, biến ngẫu nhiên là ngôn ngữ để mô tả thị trường vốn luôn chịu tác động bởi các yếu tố bất ngờ. Để xây dựng mô hình, các chuyên gia sẽ trích xuất các cú sốc ngẫu nhiên tại từng bước thời gian nhằm mô phỏng các kịch bản biến động giá có thể xảy ra tiếp theo. Nếu không có biến ngẫu nhiên, chúng ta không thể thực hiện các mô phỏng Monte Carlo hay định giá quyền chọn.
Chúng ta thường chia biến ngẫu nhiên thành hai loại khác nhau:
- Biến ngẫu nhiên rời rạc (discrete random variable): như trong Bài 3. Random Walk
- Biến ngẫu nhiên liên tục (continuous random variable): như trong Bài 4. Brownian Motion
Cách xử lý mỗi loại có sự khác biệt, nhưng nguyên lý cơ bản nền tảng thì giống nhau. Mỗi biến ngẫu nhiên đều tuân theo một phân phối xác suất, một hàm số dùng để mô tả chính nó. Với một biến ngẫu nhiên $X$ cho trước, chúng ta biểu diễn xác suất để $X$ bằng một giá trị $x$ là $P(X = x)$.
1.1. Biến ngẫu nhiên rời rạc
Hãy nghĩ về những thứ bạn có thể đếm được bằng tay. Số lần tung đồng xu hiện mặt ngửa, số chấm trên con xúc xắc, hay số lượng cổ phiếu bạn mua… đó là các biến ngẫu nhiên rời rạc.
Để mô tả chúng, ta dùng hàm khối xác suất (PMF), ký hiệu là $p_X(x)$ hay viết gọn lại là $p(x)$, được định nghĩa như sau:
\[p(x) = P(X = x) \tag{ii.1}\]Có thể hiểu PMF như một bảng phân bổ trọng lượng. Xác suất chỉ tập trung tại các giá trị cụ thể (như 1, 2, 3,…), xác suất bằng 0 tại những điểm ở giữa (như 1.5).
Hai quy tắc vàng bạn cần nhớ:
- $0 \leq p(x) \leq 1$: Xác suất $p(x)$ phải nằm từ 0 đến 1, không ai nói “khả năng xảy ra là 120%” cả.
- $\sum p(x) = 1$: Tổng xác suất của tất cả mọi kết quả $p(x)$ cộng lại phải bằng đúng 1.
Dù là rời rạc hay liên tục, chúng ta còn có một công cụ mô tả khác là hàm phân phối tích lũy (CDF), ký hiệu là $F_X(x)$, được định nghĩa như sau:
\[F_X(x) = P(X \le x) \tag{ii.2}\]Hàm CDF trả lời cho câu hỏi “xác suất để kết quả nhỏ hơn hoặc bằng $x$ là bao nhiêu?”. Với ví dụ trên, để biết xác suất tung được mặt nhỏ hơn hoặc bằng 3, bạn cần cộng dồn xác suất của các mặt 1, 2, và 3.
Dưới đây là biểu đồ minh họa hàm khối xác suất và hàm phân phối tích lũy.
- Phần trên (PMF): Bạn sẽ thấy các điểm đứng riêng biệt, thể hiện việc xác suất chỉ tồn tại tại các giá trị nguyên cụ thể (0, 1, 2…). Độ cao của mỗi điểm chính là xác suất chính xác để sự kiện đó xảy ra, ví dụ $P(X = 5)$ là giá trị cao nhất trong biểu đồ trên.
- Phần dưới (CDF): Đồ thị có dạng hình bậc thang? Đây là đặc điểm nhận dạng quan trọng nhất của biến rời rạc – xác suất không thay đổi khi ở giữa hai số nguyên, nó chỉ nhảy vọt lên khi chạm đến giá trị có khả năng xảy ra tiếp theo. Giá trị tại một điểm $x$ cho biết xác suất để biến ngẫu nhiên nhận giá trị nhỏ hơn hoặc bằng $x$.

Dù giá cổ phiếu thường được coi là liên tục, nhưng thực tế các Quant vẫn sử dụng biến ngẫu nhiên rời rạc trong định giá phái sinh với mô hình cây nhị phân, hay để mô phỏng xác suất khách hàng vỡ nợ.
1.2. Biến ngẫu nhiên liên tục
Khác với việc đếm bằng tay, biến liên tục mô tả những thứ đo lường được trên một thước đo. Chiều cao của một người, thời gian chờ xe bus, hay tỉ suất lợi nhuận của cổ phiếu… đó là các biến liên tục.
Vì có vô số kết quả tiềm năng, xác suất để biến ngẫu nhiên liên tục nhận chính xác một giá trị cụ thể ví dụ $P(X = 1)$ luôn bằng 0. Thay vì tìm xác suất tại một điểm, chúng ta cần tìm xác suất trong một khoảng. Để làm điều này, ta dùng hàm mật độ xác suất (PDF), ký hiệu là $f_X(x)$, sao cho:
\[P(a < X < b) = \int_a^b f_X(x) \, dx \tag{ii.3}\]Xác suất lúc này chính là diện tích nằm dưới đường cong của hàm PDF. Cần lưu ý rằng vì xác suất tại một điểm riêng lẻ bằng 0, nên xác suất tại các điểm chặn của một khoảng cũng bằng 0. Do đó các xác suất dưới đây là như nhau.
\[P(a \leq X \leq b) = P(a < X \leq b) = P(a \leq X < b) = P(a < X < b) \tag{ii.4}\]Tương tự như phần phân phối rời rạc, hàm PDF cần thỏa mãn hai yêu cầu sau:
- $f_X(x) \geq 0$ với mọi giá trị của $X$: PDF không bao giờ âm.
- $P(-\infty < X < \infty) = \int_{-\infty}^{\infty} f_X(x) \, dx = 1$: Tổng diện tích dưới đường cong phải bằng 1.
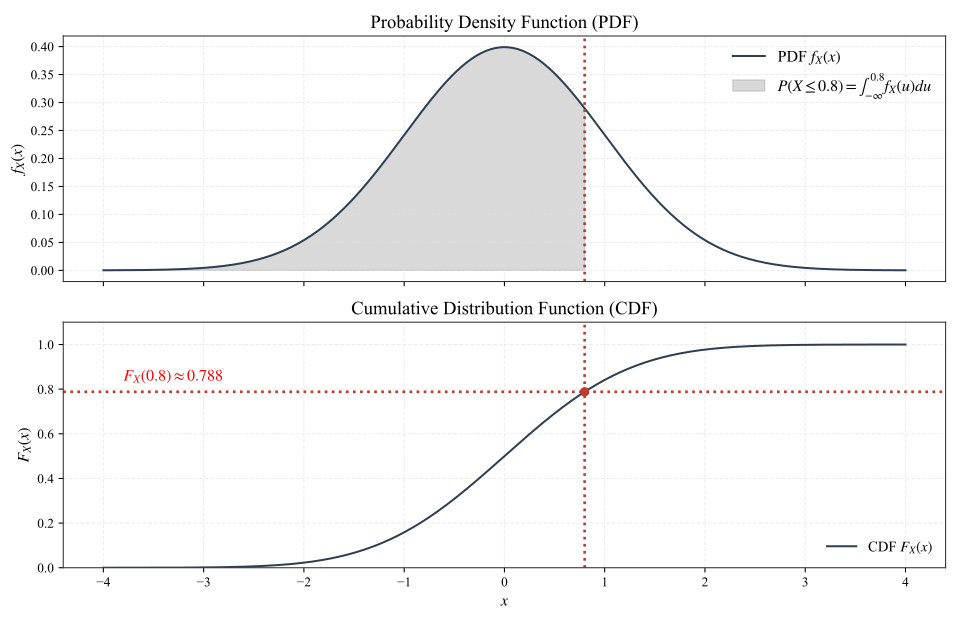
Hàm phân phối tích lũy tại giá trị $x$ chính là tích phân (tổng xác suất) của hàm mật độ xác suất từ $-\infty$ cho đến $x$.
\[F_X(x) = \int_{-\infty}^x f_X(u) \, du \tag{ii.5}\]và ngược lại hàm mật độ xác suất $f_X(x)$ là đạo hàm của hàm phân phối tích lũy $F_X(x)$
\[f_X(x) = \frac{d}{dx} F_X(x) \tag{ii.6}\]Dưới đây là biểu đồ minh họa mối quan hệ giữa hai hàm. Biểu đồ này giải thích cách chúng ta chuyển đổi từ PDF sang CDF thông qua phép tính tích phân – diện tích dưới đường cong. Ngược lại, nếu bạn biết đạo hàm – độ dốc của CDF, bạn sẽ tìm lại được hàm PDF.
- Phần trên (PDF): Đường cong hình chuông biểu diễn mật độ xác suất tại từng điểm. Phần diện tích tô màu dưới đường cong, tính từ $-\infty$ đến một giá trị $x$ cụ thể (trong hình $x = 0.8$), chính là giá trị của tích phân: $\int_{-\infty}^{x} f_X(u) \, du$. Diện tích này đại diện cho xác suất $P(X \leq x)$.
- Phần dưới (CDF): Đường cong này biểu diễn tổng xác suất tích lũy. Độ cao (giá trị trục $y$) của đường CDF tại điểm $x = 0.8$ tương ứng chính xác với diện tích phần được tô màu ở biểu đồ PDF phía trên. Khi $x$ tiến dần về dương vô cùng, giá trị của CDF sẽ tiến dần về 1.
2. Các đặc trưng của biến ngẫu nhiên
Nếu biến ngẫu nhiên là một hộp đen chứa đựng vô vàn kịch bản có thể xảy ra của thị trường, thì các chỉ số thống kê chính là bộ công cụ giúp chúng ta mở khóa chiếc hộp đó.
Thay vì quan sát từng điểm dữ liệu rời rạc, các Quant tập trung vào việc tóm tắt toàn bộ dữ liệu thông qua các đặc trưng cốt lõi. Trong tài chính, việc xác định các đặc trưng này không chỉ là giải toán, mà là quá trình chuyển đổi từ sự bất định sang rủi ro có thể đo lường.
2.1. Kỳ vọng: Điểm dừng trung bình
Với chiếc hộp đen cho trước, câu hỏi của một nhà đầu tư luôn là: “trung bình thì tôi sẽ nhận được bao nhiêu?”. Trong một mẫu dữ liệu khổng lồ với rất nhiều quan sát, chúng ta không thể chọn đại một con số để nói về tương lai. Kỳ vọng của một biến ngẫu nhiên chính là giá trị đại diện – một mỏ neo cho toàn bộ dữ liệu đó. Tùy vào loại dữ liệu chúng ta đang xử lý mà công thức sẽ khác nhau một chút.
Biến ngẫu nhiên rời rạc
Kỳ vọng là tổng của các giá trị $x_i$ có thể xảy ra, mỗi giá trị được nhân trọng số bởi xác suất xuất hiện $p(x_i)$ của nó.
\[\mathbb{E}[X] = \sum_{i=1}^{n} x_i p(x_i) \tag{ii.7}\]Ví dụ: Bạn dự báo cổ phiếu A trong năm tới có: 30% khả năng tăng 20% (kinh tế tốt), 50% khả năng tăng 5% (kinh tế ổn định), 20% khả năng giảm 10% (khủng hoảng). Kỳ vọng lợi nhuận sẽ là:
\[\mathbb{E}[X] = (20\% \times 0.3) + (5\% \times 0.5) + (-10\% \times 0.2) = 6.5\%\]Khi khả năng xảy ra của các biến cố $x_i$ là như nhau thì kỳ vọng đơn giản là trung bình cộng:
\[\mathbb{E}[X] = \frac{1}{n} \sum_{i=1}^{n} x_i \tag{ii.8}\]Biến ngẫu nhiên liên tục
Khi lợi nhuận cổ phiếu có thể là bất kỳ con số nào, chúng ta không thể cộng từng điểm được nữa mà phải dùng đến phép tính tích phân.
\[\mathbb{E}[X] = \int_{-\infty}^{+\infty} x f(x) \, dx \tag{ii.9}\]Đừng nhầm lẫn giữa công thức xác suất (ii.3) và công thức kỳ vọng (ii.9) (ở đây ta có thêm biến $x$ trong tích phân). Xác suất là diện tích dưới đường cong $f(x)$, kỳ vọng là điểm cân bằng của đường cong đó. Hãy tưởng tượng hàm mật độ xác suất là một vật thể có hình dáng lồi lõm. Nếu bạn đặt vật thể đó lên một cái bập bênh, giá trị kỳ vọng chính là vị trí đặt điểm tựa sao cho cái bập bênh nằm thăng bằng hoàn toàn.
Tính chất của kỳ vọng
- Kỳ vọng của một hằng số: $\mathbb{E}[C] = C$. Nếu ngân hàng cam kết lãi suất tiết kiệm là 6% cố định, thì kỳ vọng của bạn luôn là 6%.
- Tính tuyến tính: $\mathbb{E}[aX + b] = a\mathbb{E}[X] + b$.
- Kỳ vọng của một tổng: $\mathbb{E}[X + Y] = \mathbb{E}[X] + \mathbb{E}[Y]$. Lợi nhuận kỳ vọng của một danh mục đầu tư bằng tổng lợi nhuận kỳ vọng của từng cổ phiếu thành phần.
- Kỳ vọng của tích (nếu X, Y độc lập): $\mathbb{E}[X Y] = \mathbb{E}[X] \mathbb{E}[Y]$.

Tính chất tuyến tính là vũ khí cực mạnh cho phép chúng ta đơn giản hóa những bài toán phức tạp. Chúng ta đã sử dụng tính chất này trong Bài 3. Random Walk, bạn còn nhớ?
- Shift: Khi bạn cộng hằng số $b$ (ví dụ chịu phí giao dịch cố định) vào mọi kết quả, toàn bộ phân phối sẽ trượt sang phải/trái. Kỳ vọng cũng trượt theo đúng một khoảng bằng $b$.
- Scaling: Khi bạn nhân hằng số $a$ (ví dụ dùng đòn bẩy margin), lợi nhuận kỳ vọng của bạn cũng sẽ được nhân lên $a$ lần. Tuy nhiên, hãy chú ý trên đồ thị: đường cong màu đỏ thấp hơn và rộng hơn – điều này minh họa việc lợi nhuận kỳ vọng tăng lên thì rủi ro cũng tăng theo tỉ lệ thuận.
Thực hành Python
Chúng ta sử dụng lại ví dụ trong Bài 5 với dữ liệu thực tế từ 4 cổ phiếu blue-chips trên sàn S&P500 như AAPL (Apple Inc.), JPM (JPMorgan Chase & Co.), JNJ (Johnson & Johnson), XOM (Exxon Mobil Corp.). Dữ liệu được lấy từ Polygon.io cho giai đoạn 01/2024 tới 01/2026.
Nếu chạy trên máy tính, bạn cần giải nén  market_data.zip và đặt cùng thư mục chứa code Python. File Excel
 Excel Workbook giúp bạn kiểm tra lại các phép tính trong code Python.

log_returns.sum() / len(log_returns) chính là công thức (ii.8). Dòng expected_return_func * 252 giúp đổi lợi suất ngày về lợi suất năm. 252 chính là số ngày giao dịch trung bình trong một năm tại thị trường chứng khoán Mỹ.
# --- 2. EXPECTED RETURN (E[R]) ---
log_returns = np.log(df_pivot / df_pivot.shift(1)).dropna()

 # Method 1: E[X] = sum(X) / n
expected_return_def = log_returns.sum() / len(log_returns)

# Method 2: built-in function
# Note: ddof=0 is used to match the population variance definition in math
expected_return_func = log_returns.mean()

print(expected_return_func * 252)
ticker
AAPL    0.174843
JNJ     0.155222
JPM     0.304700
XOM     0.144496
Kết quả cho thấy: JPM cho giá trị ~0.3047 nghĩa là lợi suất trung bình 30.47%/năm trong 2 năm qua. Điều này phản ánh một giai đoạn tăng trưởng mạnh của ngành ngân hàng. XOM có mức sinh lời thấp nhất trong nhóm (~0.1444). Tuy nhiên, trong quản trị danh mục, một cổ phiếu có lợi suất thấp đôi khi vẫn được giữ lại nếu nó ít tương quan với các mã còn lại vì giúp giảm rủi ro tổng thể.
2.2. Phương sai: Thước đo của rủi ro
Trong tài chính, có một quy luật bất biến high risk, high return (Hình 3). Nhưng làm sao để đo lường cái gọi là rủi ro một cách định lượng? Cách đơn giản nhất là sử dụng phương sai để đo lường mức độ phân tán của dữ liệu xung quanh giá trị kỳ vọng.
- Nếu phương sai thấp: Giá cổ phiếu biến động rất ít, gần sát với mức trung bình (ít rủi ro).
- Nếu phương sai cao: Giá nhảy múa hỗn loạn, lúc tăng cực mạnh, lúc giảm cực sâu (rủi ro cao).
Phương sai ký hiệu là $Var(X)$ hoặc $\sigma^2$, được định nghĩa là trung bình của bình phương các sai số. Ký hiệu $\mu$ cho giá trị kỳ vọng $\mathbb{E}[X]$, ta có công thức phương sai như sau:
Biến ngẫu nhiên rời rạc
\[Var(X) = \sum_{i=1}^{n} (x_i - \mu)^2 p(x_i) \tag{ii.10}\]Biến ngẫu nhiên liên tục
\[Var(X) = \int_{-\infty}^{+\infty} (x - \mu)^2 p(x) \, dx \tag{ii.11}\]Thay vì phải trừ từng giá trị cho $\mu$ rồi bình phương (rất tốn thời gian), chúng ta thường sử dụng một tính chất cực kỳ quan trọng. Phần chứng minh được trình bày dưới Phụ lục (A1).
\[Var(X) = \mathbb{E}[X^2] - (\mathbb{E}[X])^2 \tag{ii.12}\]Độ lệch chuẩn
Mặc dù phương sai rất tuyệt vời về mặt toán học, nhưng đơn vị của nó là bình phương khiến rất khó hình dung trong thực tế. Để đưa rủi ro về cùng một đơn vị với lợi nhuận (%), chúng ta sử dụng độ lệch chuẩn ký hiệu là $\sigma$:
\[\sigma = \sqrt{Var(X)} \tag{ii.13}\]Tại sao con số này lại quan trọng? Trong tài chính, nếu lợi nhuận tuân theo phân phối chuẩn, độ lệch chuẩn sẽ cho bạn biết nhanh các ngưỡng an toàn.
- Khoảng 68% khả năng lợi nhuận thực tế sẽ nằm trong khoảng $[\mathbb{E}[X] - \sigma, \mathbb{E}[X] + \sigma]$.
- Khoảng 95% khả năng lợi nhuận thực tế sẽ nằm trong khoảng $[\mathbb{E}[X] - 2\sigma, \mathbb{E}[X] + 2\sigma]$.
- Khoảng 99% khả năng lợi nhuận thực tế sẽ nằm trong khoảng $[\mathbb{E}[X] - 3\sigma, \mathbb{E}[X] + 3\sigma]$.
Ví dụ: Nếu cổ phiếu có $\mu = 12\%$ và $\sigma = 10\%$, bạn có thể tự tin khoảng 95% rằng năm tới bạn sẽ không lỗ quá -8% ($12\% - 2 \times 10\%$) và không lãi quá 32% ($12\% + 2 \times 10\%$). Đây chính là cách để nhà đầu tư lập kế hoạch quản trị rủi ro.

Thực hành Python
Tại sao lại là np.sqrt(252)? Vì chúng ta giả định các ngày giao dịch là độc lập. Khi đó, phương sai có thể cộng dồn theo thời gian: $Var[X_{annual}] = Var[X_{daily}] \times 252$. Độ lệch chuẩn là căn bậc hai của phương sai, nên khi quy đổi ra năm, ta phải dùng căn bậc hai của thời gian \(\sigma_{annual} = \sigma_{daily} \times \sqrt{252}\).
# --- 3. VARIANCE & STD DEV ---
# Method 1: Mathematical Definition Var(X) = E[X^2] - (E[X])^2
variance_def = (log_returns**2).mean() - (log_returns.mean())**2

# Method 2: Python built-in function, ddof=0 is used to match the population definition
variance_func = log_returns.var(ddof=0)

print(np.sqrt(variance_func) * np.sqrt(252))
ticker
AAPL    0.276182
JNJ     0.177937
JPM     0.245571
XOM     0.219428
Kết quả cho thấy: AAPL có mức biến động cao nhất trong nhóm (27.62%). Điều này dễ hiểu vì cổ phiếu công nghệ thường nhạy cảm với tin tức thị trường và kỳ vọng tăng trưởng. JNJ có mức biến động thấp nhất (17.79%), đặc trưng của ngành chăm sóc sức khỏe và hàng tiêu dùng thiết yếu.
2.3. Hiệp phương sai: Chìa khóa của sự đa dạng hóa
Nếu phương sai cho bạn biết một cổ phiếu nhảy múa ra sao, thì hiệp phương sai cho bạn biết hai cổ phiếu nhảy múa cùng nhau như thế nào. Hiệp phương sai đo lường mối quan hệ tuyến tính giữa hai biến ngẫu nhiên. Khi hiệp phương sai giữa hai biến lớn hơn 0, chúng có quan hệ đồng biến và ngược lại.
Hiệp phương sai giữa hai biến ngẫu nhiên $X, Y$ được kí hiệu là $Cov(X,Y)$ được tính như sau
\[Cov(X, Y) = \mathbb{E}[(X - \mathbb{E}[X])(Y - \mathbb{E}[Y])] \tag{ii.14}\]hoặc tính nhanh bằng:
\[Cov(X, Y) = \mathbb{E}[XY] - \mathbb{E}[X]\mathbb{E}[Y] \tag{ii.15}\]Phần chứng minh được trình bày dưới Phụ lục (A2).
Trường hợp xác suất đồng nhất: mọi cặp giá trị $(x_i, y_i)$ đều có xác suất xảy ra là $p_i = \frac{1}{n}$, kỳ vọng $\mathbb{E}[\dots]$ trở thành trung bình cộng đơn giản của các sai phân. Công thức hiệp phương sai có thể viết lại như sau:
\[Cov(X, Y) = \frac{1}{n} \sum_{i=1}^{n} (x_i - \mathbb{E}[X])(y_i - \mathbb{E}[Y]) \tag{ii.16}\]Hệ số tương quan
Hiệp phương sai có một nhược điểm là đơn vị rất khó hiểu. Để chuẩn hóa, chúng ta dùng hệ số tương quan ($\rho$), đưa mọi thứ về khoảng từ $-1$ đến $1$:
\[\rho_{XY} = \frac{Cov(X, Y)}{\sigma_X \sigma_Y} \tag{ii.17}\]- $\rho = 1$: Tương quan thuận hoàn hảo. Rủi ro nhân đôi.
- $\rho = -1$: Tương quan nghịch hoàn hảo. Rủi ro phi hệ thống có thể được triệt tiêu hoàn toàn.
- $\rho = 0$: Không có mối tương quan.
Tại sao Quant lại ám ảnh bởi tương quan? Trong lý thuyết danh mục đầu tư, chúng ta đạt được trạng thái đa dạng hóa tối ưu khi $\rho = -1$. Tại điểm này, các biến động ngược chiều của các tài sản sẽ tự triệt tiêu lẫn nhau, cho phép nhà đầu tư thiết lập một danh mục có rủi ro cực tiểu trong khi vẫn duy trì được mức lợi nhuận mục tiêu.
Ma trận hiệp phương sai
Khi danh mục của bạn không chỉ có 2 mà là 10, hay 100 cổ phiếu, chúng ta cần một cách hệ thống để quản lý mối quan hệ giữa chúng. Đó chính là lúc ma trận hiệp phương sai xuất hiện. Với một danh mục gồm $n$ tài sản, ma trận hiệp phương sai ($\mathbf{\Sigma}$) là một ma trận vuông $n \times n$.
\[\mathbf{\Sigma} = \begin{bmatrix} Var(X_1) & Cov(X_1, X_2) & \dots & Cov(X_1, X_n) \\ Cov(X_2, X_1) & Var(X_2) & \dots & Cov(X_2, X_n) \\ \vdots & \vdots & \ddots & \vdots \\ Cov(X_n, X_1) & Cov(X_n, X_2) & \dots & Var(X_n) \end{bmatrix} \tag{ii.18}\]Các tính chất cần ghi nhớ:
- Đường chéo chính: Là phương sai của từng cổ phiếu $Var(X_i)$, cho biết rủi ro nội tại của nó.
- Các phần tử ngoài đường chéo: Là hiệp phương sai giữa các cặp cổ phiếu.
- Tính đối xứng: $Cov(X_i, X_j) = Cov(X_j, X_i)$
Tương tự, ta có ma trận tương quan ($\mathbf{R}$) như dưới đây. Điểm khác biệt quan trọng nhất là các phần tử trên đường chéo chính luôn bằng 1, vì tương quan của một biến với chính nó luôn hoàn hảo.
\[\mathbf{R} = \begin{bmatrix} 1 & \rho_{12} & \dots & \rho_{1n} \\ \rho_{21} & 1 & \dots & \rho_{2n} \\ \vdots & \vdots & \ddots & \vdots \\ \rho_{n1} & \rho_{n2} & \dots & 1 \end{bmatrix} \tag{ii.19}\]Để tính rủi ro của cả một danh mục, chúng ta không đơn giản là cộng phương sai của từng mã. Công thức tính rủi ro danh mục sử dụng đại số tuyến tính như sau:
\[\sigma^2_p = \vec{w}^T \Sigma \vec{w} \tag{ii.20}\]Trong đó:
- $\vec{w}$ là vector tỷ trọng của các cổ phiếu trong danh mục.
- $\mathbf{\Sigma}$ là ma trận hiệp phương sai giữa các cổ phiếu.
Công thức này cho thấy rủi ro danh mục phụ thuộc mật thiết vào việc các cổ phiếu tương tác với nhau như thế nào thông qua ma trận $\mathbf{\Sigma}$. Như đã thảo luận, khi các phần tử ngoài đường chéo $Cov(X_i, X_j)$ mang giá trị âm hoặc rất nhỏ, tổng rủi ro danh mục $\sigma^2_p$ sẽ giảm đáng kể.
Thực hành Python
# --- 4. COVARIANCE & CORRELATION MATRIX ---
cov_matrix = log_returns.cov(ddof=0)
cor_matrix = log_returns.corr()

print(cov_matrix)
print(cor_matrix)
ticker      AAPL       JNJ       JPM       XOM
ticker
AAPL    0.000303  0.000008  0.000083  0.000056
JNJ     0.000008  0.000126  0.000019  0.000024
JPM     0.000083  0.000019  0.000239  0.000070
XOM     0.000056  0.000024  0.000070  0.000191

ticker      AAPL       JNJ       JPM       XOM
ticker
AAPL    1.000000  0.039730  0.307609  0.233967
JNJ     0.039730  1.000000  0.111412  0.157417
JPM     0.307609  0.111412  1.000000  0.328261
XOM     0.233967  0.157417  0.328261  1.000000
Ma trận hiệp phương sai chứa đựng thông tin về phương sai của từng mã và mối quan hệ biến động giữa chúng.
- Trên đường chéo chính, AAPL cho phương sai lớn nhất (0.000303), củng cố nhận định ở phần trước rằng đây là mã biến động mạnh nhất.
- Các phần tử ngoài đường chéo đều là số dương. Điều này có nghĩa là các mã cổ phiếu này có xu hướng di chuyển cùng chiều với nhau: khi một mã lên, tất cả các mã khác cùng lên và ngược lại.
- $Cov[\text{AAPL}, \text{JNJ}]$ hoàn toàn bằng $Cov[\text{JNJ}, \text{AAPL}]$. Đây là tính chất đối xứng của ma trận hiệp phương sai $\mathbf{\Sigma} = \mathbf{\Sigma}^T$.
Ma trận tương quan là phiên bản chuẩn hóa giúp chúng ta đọc hiểu dễ dàng hơn vì các giá trị luôn nằm trong khoảng $[-1, 1]$. Ma trận này thường được biểu diển dưới dạng heat-map (Hình 5) để có cái nhìn trực quan hơn, ta có thể thấy ngay cặp cổ phiếu nào có tương quan cao (màu đậm) hoặc thấp (màu nhạt).

- Đường chéo chính luôn bằng 1. Một cổ phiếu luôn biến động hoàn hảo với chính nó.
- Cặp cổ phiếu AAPL/JNJ: Tương quan cực thấp ~0.039 gần như bằng 0 cho thấy hai mã này gần như không liên quan đến nhau. Kết hợp hai mã này sẽ giảm rủi ro danh mục đáng kể.
- Cặp JPM/XOM (~0.328) và JPM/AAPL (~0.307): Đây là mức tương quan trung bình, cho thấy có một chút kết nối do các yếu tố kinh tế vĩ mô (như lãi suất, lạm phát) tác động lên cả ngành tài chính, năng lượng và công nghệ, nhưng vẫn đủ thấp để mang lại lợi ích đa dạng hóa.
3. Ứng dụng trong quản lý danh mục đầu tư
Sự hiểu biết về ma trận hiệp phương sai và ma trận tương quan không chỉ dừng lại ở mặt lý thuyết hay các con số thống kê tĩnh. Đối với một Quant, đây chính là bộ công cụ định lượng cốt lõi trong quản lý danh mục đầu tư thực tế. Trong phần này, ta sẽ sử dụng các kết quả tính toán ở trên để xem cách ma trận hiệp phương sai làm giảm rủi ro tổng thể của danh mục như thế nào.
Giả sử ta xây dựng một danh mục đầu tư gồm 4 mã cổ phiếu trên, mỗi mã chiếm 25% tỷ trọng. Ta tiến hành đánh giá hiệu suất của danh mục này xem sao.
# --- 5. PORTFOLIO RISK CALCULATION ---
# Equal-weight Portfolio
weights = np.array([0.25, 0.25, 0.25, 0.25])
portfolio_variance_daily = weights.T @ cov_matrix @ weights # Formula: Var_p = w.T * Sigma * w
portfolio_vol_annual = np.sqrt(portfolio_variance_daily) * np.sqrt(252)
print(f"Portfolio Annualized Volatility: {portfolio_vol_annual:.4f}")

# Compare with individual volatilities
individual_vols = np.sqrt(np.diag(cov_matrix)) * np.sqrt(252)
print("Individual Annualized Volatility:", individual_vols)
Bạn có thể thấy phép màu của chiến lược đa dạng hóa trong bảng kết quả dưới đây.
Portfolio Annualized Volatility: 0.1474
Individual Annualized Volatility: [0.27618203 0.17793708 0.2455711  0.21942764]
Hãy thử so sánh con số portfolio_vol_annual với các individual_vols. Rủi ro của danh mục (~14.74%) thấp hơn nhiều so với mã rủi ro nhất AAPL (~27.61%), thậm chí còn thấp hơn cả mã ít rủi ro nhất JNJ (~17.79%). Tại sao? Vì các giá trị ngoài đường chéo trong Ma trận tương quan ở mức thấp, khi các mã không nhảy cùng một điệu, biến động của mã này sẽ triệt tiêu bớt biến động của mã kia.
Để có cái nhìn trực quan, chúng ta thử vẽ đồ thị sự biến động giá trị của danh mục đầu tư cùng những cổ phiếu đơn lẻ theo thời gian.

- Bạn sẽ thấy các đường màu xám (cổ phiếu riêng lẻ) nhảy lên xuống rất gắt, đặc biệt là AAPL hay JPM. Trong khi đó, đường màu xanh (danh mục) có xu hướng mượt mà hơn.
- Dù danh mục có thể không đạt đỉnh cao nhất như mã thành công nhất, nhưng nó bảo vệ nhà đầu tư khỏi việc sụt giảm quá sâu của mã tệ nhất tại một thời điểm bất kỳ. Điều này thể hiện rõ nhất trong giai đoạn thị trường sụp đổ 04/2025.
Cuối cùng, ta vẽ thử biểu đồ Risk-Return Scatter Plot, linh hồn của lý thuyết danh mục đầu tư hiện đại.

- Bạn sẽ thấy ngôi sao (danh mục đầu tư với tỷ trọng đều) nằm dịch hẳn về phía bên trái trục X so với bốn chấm đen (cổ phiếu đơn lẻ). Đây là minh chứng trực quan cho việc đa dạng hóa giúp triệt tiêu một cách thần kỳ rủi ro không hệ thống của từng mã cổ phiếu. Ngôi sao nằm ở giữa các cổ phiếu thành phần trên trục Y, cho thấy bạn vẫn nhận được mức lợi nhuận trung bình của các tài sản, nhưng với một cái giá về rủi ro rẻ hơn nhiều.
- Đám mây màu vàng đại diện cho hàng ngàn tổ hợp danh mục ngẫu nhiên (tỷ trọng không còn là 25% cho mỗi mã cổ phiếu). Bạn có thể thấy rằng hầu hết các điểm trong đám mây đều nằm về phía bên trái so với các cổ phiếu riêng lẻ. Điều này chứng minh rằng việc kết hợp nhiều tài sản giúp giảm rủi ro đáng kể mà không nhất thiết phải hy sinh lợi nhuận.
Lời khuyên cuối cùng “Đừng bỏ trứng vào cùng một giỏ”. Trong đầu tư, sai lầm lớn nhất không phải là chọn sai một cổ phiếu, mà là đặt tất cả niềm tin và tài sản vào một cổ phiếu duy nhất. Hãy để toán học giúp bạn chia số trứng đó ra một cách khoa học nhất!
4. Tóm tắt và thảo luận
Chúng ta đã đi qua một hành trình từ những khái niệm toán học thuần túy như kỳ vọng, phương sai cho đến ứng dụng thực tiễn trong việc quản trị một danh mục đầu tư. Dưới đây là những điểm cần ghi nhớ:
-
Biến ngẫu nhiên là nguyên liệu. Mọi mô hình định giá hay quản trị rủi ro hiện đại đều bắt đầu từ việc giả định lợi suất cổ phiếu là một biến ngẫu nhiên tuân theo một phân phối nào đó.
-
Đa dạng hóa là “bữa trưa miễn phí” duy nhất. Trong tài chính, hiếm khi bạn có thể giảm rủi ro mà không làm giảm lợi nhuận. Nhưng nhờ vào việc kết hợp các tài sản có tương quan thấp, chúng ta đã chứng minh được rằng rủi ro danh mục có thể thấp hơn cả cổ phiếu an toàn nhất trong nhóm (như trường hợp của JNJ). Đây không còn là một lời khuyên cảm tính, nó được định lượng chính xác qua ma trận hiệp phương sai $\mathbf{\Sigma}$ và công thức $\sigma^2_p = \vec{w}^T \mathbf{\Sigma} \vec{w}$.
-
Thực hành Python
market_data.zip -
Thực hành Excel
Excel Workbook
Chúng ta có thể làm tốt hơn không? Trong ví dụ trên, chúng ta đã xây dựng danh mục đầu tư với tỷ trọng đều (25% cho mỗi mã cổ phiếu). Đây là một cách tiếp cận đơn giản và hiệu quả, nhưng liệu nó đã là tốt nhất? Trong đám mây màu vàng có danh mục nào tốt hơn? Làm sao để tìm ra một bộ tỷ trọng $\vec{w}$ với cùng một mức rủi ro, cho lợi nhuận cao nhất có thể? Hẹn các bạn trong một ngày không xa, chúng ta sẽ cùng tìm hiểu về tối ưu hóa danh mục đầu tư.
Appendix
A1. Chứng minh công thức phương sai từ kỳ vọng
\[\begin{aligned} Var(X) &= \mathbb{E}[(X - \mu)^2] \\ &= \mathbb{E}[X^2 - 2\mu X + \mu^2] \\ &= \mathbb{E}[X^2] - \mathbb{E}[2\mu X] + \mathbb{E}[\mu^2] \\ &= \mathbb{E}[X^2] - 2\mu \mathbb{E}[X] + \mu^2 \\ &= \mathbb{E}[X^2] - 2\mu \cdot \mu + \mu^2 \\ &= \mathbb{E}[X^2] - 2\mu^2 + \mu^2 \\ &= \mathbb{E}[X^2] - \mu^2 \\ &= \mathbb{E}[X^2] - (\mathbb{E}[X])^2 \end{aligned} \tag{ii.A1.1}\]Điều cần chứng minh, công thức (ii.12).
A2. Chứng minh công thức hiệp phương sai từ kỳ vọng
\[\begin{aligned} Cov(X, Y) &= \mathbb{E}[(X - \mathbb{E}[X])(Y - \mathbb{E}[Y])] \\ &= \mathbb{E}[XY - X \mathbb{E}[Y] - Y \mathbb{E}[X] + \mathbb{E}[X]\mathbb{E}[Y]] \\ &= \mathbb{E}[XY] - \mathbb{E}[X \mathbb{E}[Y]] - \mathbb{E}[Y \mathbb{E}[X]] + \mathbb{E}[\mathbb{E}[X]\mathbb{E}[Y]] \\ &= \mathbb{E}[XY] - \mathbb{E}[Y]\mathbb{E}[X] - \mathbb{E}[X]\mathbb{E}[Y] + \mathbb{E}[X]\mathbb{E}[Y] \\ &= \mathbb{E}[XY] - \mathbb{E}[X]\mathbb{E}[Y] - \mathbb{E}[X]\mathbb{E}[Y] + \mathbb{E}[X]\mathbb{E}[Y] \\ &= \mathbb{E}[XY] - \mathbb{E}[X]\mathbb{E}[Y] \end{aligned} \tag{ii.A2.1}\]Điều cần chứng minh, công thức (ii.15).