Bài 5: Ứng dụng GBM trong thực tiễn
GBM không chỉ để mô phỏng cho vui. Cùng đi từ kiểm định dữ liệu thực, hiệu chuẩn tham số, đến ứng dụng thực tế (dự báo, quản trị rủi ro, định giá phái sinh).
Chúng ta đã đi qua một hành trình từ những bước đi ngẫu nhiên đến dòng chảy liên tục của chuyển động Brown. Nhưng lý thuyết sẽ chỉ là lý thuyết nếu chúng ta không thể áp dụng vào thực tế sinh động. Liệu chỉ số S&P 500 hay giá cổ phiếu Apple có thực sự tuân theo quy luật mà các nhà toán học đã đặt ra?
Trong bài viết này, chúng ta sẽ tạm rời xa các công thức khô khan để bắt tay vào kiểm chứng với dữ liệu thực tế xem thị trường có chuẩn hay không, học cách nắm bắt đặc tính của cổ phiếu qua bộ tham số $\mu, \sigma$, và cuối cùng tìm hiểu ứng dụng thực tế của GBM từ dự báo kịch bản tương lai của giá cổ phiếu, quản trị rủi ro, tới định giá phái sinh.
Trong bài viết này:
- 1. Normality Test: Kiểm định phân phối chuẩn
- 2. Calibration: Hiệu chuẩn
- 3. Ứng dụng thực tế của GBM
- 4. Quant Analyst vs. Quant Risk: Sự đối lập về triết lý mô hình
- 5. Tóm tắt và thảo luận
1. Normality Test: Kiểm định phân phối chuẩn
Trước khi áp dụng mô hình vào thực tế, chúng ta cần trả lời một câu hỏi nền tảng: dữ liệu thực tế có chuẩn như lý thuyết yêu cầu không? Bachelier giả định lợi nhuận tuyệt đối (absolute return), còn GBM thì yêu cầu tỷ suất lợi nhuận, gọi tắt là lợi suất (log return) phải tuân theo phân phối chuẩn. Hãy cùng kiểm chứng điều này với dữ liệu lịch sử.
1.1. Thu thập dữ liệu
Để thực hiện, chúng ta cần dữ liệu lịch sử chất lượng, tốt nhất là giá đóng cửa điều chỉnh (adjusted close) đã loại bỏ tác động của chia tách (split) và cổ tức (dividend). Có rất nhiều nguồn cho phép bạn truy cập miễn phí dữ liệu lịch sử giao dịch chứng khoán. Các lựa chọn này trải dài từ việc tải file .csv thủ công trên trang web cho đến các API mạnh mẽ giúp tự động lấy dữ liệu dành cho lập trình viên. Dưới đây là một vài nguồn dữ liệu miễn phí tốt năm 2026 để bạn tham khảo.
Nếu bạn chỉ cần một file .csv để mở trong Excel, đây là những lựa chọn tốt nhất:
- Yahoo Finance: Vẫn được coi là tiêu chuẩn vàng cho việc tải dữ liệu nhờ tính bao quát thị trường và hoàn toàn miễn phí. Nó cung cấp dữ liệu của hầu hết các sàn chứng khoán lớn trên thế giới và cả ở Việt Nam. Cách làm: đăng nhập, tìm kiếm mã chứng khoán, ví dụ AAPL (Apple Inc.), nhấp vào tab Historical Data, chọn khoảng thời gian và nhấn Download.
- Investing.com: Cung cấp cơ sở dữ liệu khổng lồ về cổ phiếu toàn cầu, các chỉ số, cũng như hàng hóa. Cách làm: đăng nhập, tìm kiếm mã chứng khoán, ví dụ JPM (JPMorgan Chase & Co.), đi đến tab Historical Data và bạn có thể Download dữ liệu trực tiếp.
- Boursorama.com: Chuyên cung cấp dữ liệu thị trường Pháp, châu Âu, và Mỹ. Cách làm: không cần đăng nhập, tìm kiếm mã chứng khoán, bạn sẽ thấy nút Download ngay trên biểu đồ chart.
Nếu bạn muốn lấy trực tiếp dữ liệu qua API, đây là một vài nguồn tham khảo:
- Alpha Vantage: Đây là API phổ biến nhất vì nó cung cấp hầu hết mọi thứ từ giá cổ phiếu, ngoại hối (Forex), tiền điện tử (Crypto) đến các chỉ báo kỹ thuật (RSI, MACD). Gói miễn phí giới hạn khoảng 25 yêu cầu/ngày, phù hợp để làm các dự án nhỏ, học tập hoặc nghiên cứu.
- Polygon.io: Nếu bạn cần dữ liệu cực nhanh và chính xác cho thị trường chứng khoán Mỹ, Polygon là lựa chọn hàng đầu. Gói miễn phí cho phép truy cập dữ liệu lịch sử trong vòng 2 năm với giới hạn 5 yêu cầu/phút.
Nên lấy dữ liệu trong khoảng 2 đến 5 năm để có đủ cỡ mẫu cho các kiểm định thống kê, nhưng không quá xa để tránh việc cấu trúc thị trường đã thay đổi quá nhiều.
1.2. Mô tả dữ liệu
Để thuận tiện cho bài viết, tôi đã chuẩn bị sẵn dữ liệu thực tế của 4 mã cổ phiếu blue-chips trên sàn S&P500: AAPL (Apple Inc.), JPM (JPMorgan Chase & Co.), JNJ (Johnson & Johnson), XOM (Exxon Mobil Corp.). Bốn mã này sẽ theo chúng ta xuyên suốt cả bài, từ kiểm định, hiệu chuẩn, cho đến các ví dụ ở phần sau. Dữ liệu được lấy từ Polygon.io, từ 01/2024–01/2026. Bạn có thể download dữ liệu tại đây  market_data.zip.

Nhìn vào biểu đồ, bạn sẽ thấy những đoạn giá bỗng dưng dốc đứng, hoặc thậm chí đứt đoạn tạo thành một khoảng trống. Hiện tượng này không hiếm trong thị trường thực, và thường gọi là các bước nhảy giá (jump). Các bước nhảy này có thể đến từ một bản báo cáo lợi nhuận khủng khiến nhà đầu tư phấn khích, hay một tin tức vĩ mô bất ngờ từ chính phủ khiến mọi người trở tay không kịp. Hãy để ý các cột màu xanh ở dưới đồ thị. Một bước nhảy lớn thường đi kèm với một cột khối lượng giao dịch cao ngất ngưởng. Nó giống như việc bạn hét lớn và có cả một đám đông hàng ngàn người cùng hò reo theo như cùng xác nhận một xu hướng mới.

Hãy thử dùng GBM để mô phỏng giá cổ phiếu Apple, để xem liệu ta có bắt được hiện tượng này vào trong mô hình hay không. Nhìn vào biểu đồ, giữa “lý thuyết màu hồng” và “thực tế màu xám” có những khoảng cách rất thú vị: đường lý thuyết (màu vàng đứt đoạn) trông hiền hơn rất nhiều so với đường giá thực tế (màu xanh) đầy gai góc. Mô hình bảo vệ bạn tốt trong điều kiện bình thường, nhưng khi thị trường biến động mạnh, nó thường đơ ra vì những cú nhảy này không nằm trong công thức toán học của nó.
1.3. Kiểm chứng với Python
Bạn có thể chạy thử trên Google Colab cho cổ phiếu AAPL (Apple Inc.). Nếu chạy trên máy tính của bạn, market_data cần đặt cùng thư mục chứa code Python.

Hàm pd.read_csv(file_path) giúp đọc file .csv và gán dữ liệu vào dataframe – một cấu trúc dữ liệu trong thư viện pandas. Hàm pd.to_datetime giúp chuẩn hóa dữ liệu thời gian sang định dạng ngày giờ.
import numpy as np
import pandas as pd
import scipy.stats as stats
import seaborn as sns

# --- 1. Load Historical Data  ---
df = pd.read_csv("market_data/AAPL.csv")
df['timestamp'] = pd.to_datetime(df['timestamp'])
   open     high    low      close   volume      vwap      timestamp            transactions  otc
0  182.160  184.26  180.934  183.63  65603041.0  182.8825  2024-01-16 05:00:00  767284  NaN
1  181.270  182.93  180.300  182.68  47317433.0  181.9201  2024-01-17 05:00:00  594632  NaN
2  186.090  189.14  185.830  188.63  78005754.0  187.9375  2024-01-18 05:00:00  787235  NaN
...
Kiểm tra nhanh dataframe df đầu vào, ta thấy 502 dữ liệu theo ngày tương đương với gần 2 năm dữ liệu (mỗi năm có 252 ngày giao dịch). Dữ liệu ta quan tâm là giá đóng cửa trong cột close. Tỷ suất lợi nhuận log_returns được tính từ cột này theo công thức $\ln(S_t/S_{t-1})$. Hàm dropna() giúp loại bỏ dữ liệu NaN trong mẫu.
# --- 2. Calculate Return ---
# GBM Model (log-return): ln(P_t / P_{t-1})
log_returns = np.log(df_prices['close'] / df_prices['close'].shift(1)).dropna()
   timestamp            close   log_returns
0  2024-01-16 05:00:00  183.63  NaN
1  2024-01-17 05:00:00  182.68  -0.005187
2  2024-01-18 05:00:00  188.63  0.032051
...
Tiếp theo, ta tính các chỉ số thống kê Skewness, Kurtosis, và kiểm định Jarque-Bera. Histogram và Q-Q Plot cũng được vẽ để kiểm tra một cách trực quan.
# --- 3. Calculate Statistics ---
s = stats.skew(log_returns)
k = stats.kurtosis(log_returns)
jb_stat, p_val = stats.jarque_bera(log_returns)

# --- 4. Plot Histograms, Q-Q Plot ---
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
sns.histplot(log_returns, kde=True, ax=axes[0], stat="density"); # Histogram
stats.probplot(log_returns, dist="norm", plot=axes[1]); # Q-Q Plot
--- AAPL (Lognormal Fit) ---
Skewness:            0.6364
Kurtosis:            11.7107
Jarque-Bera P-value: 0.0000e+00

Kết quả cho thấy dữ liệu thực tế của Apple có hiện tượng đuôi béo và đỉnh nhọn rõ rệt, kiểm định Jarque-Bera cũng bác bỏ hoàn toàn giả thuyết phân phối chuẩn. Phần đỉnh vọt lên cao và nhọn nhiều hơn đường màu đỏ, được xác nhận qua chỉ số Kurtosis cực cao (11.7107 so với 0). Quan trọng hơn, phần đuôi ở biểu đồ Q-Q Plot bị uốn cong ra xa đường chéo $45^\circ$ ở cả hai đầu, minh chứng cho việc các biến động cực đoan (sập sàn hoặc tăng trần) xảy ra thường xuyên hơn so với dự báo lý thuyết.
Cổ phiếu công nghệ có thể vi phạm các giả định phân phối chuẩn do đặc thù tăng trưởng mạnh, nhưng cổ phiếu tài chính JPM (JPMorgan Chase & Co.), y tế JNJ (Johnson & Johnson), hay năng lượng XOM (Exxon Mobil Corp.) thì sao? Kiểm tra tương tự cho JPM, JNJ, XOM ta được biểu đồ dưới đây.
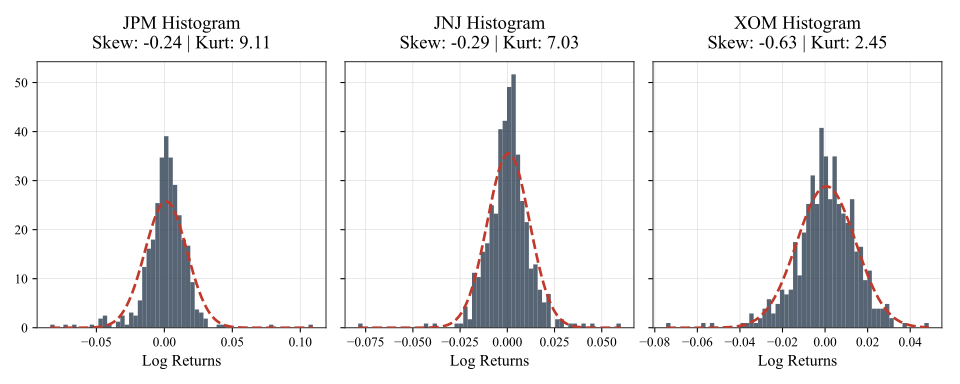
Kết quả cho thấy cả 4 cổ phiếu đều vi phạm phân phối chuẩn ở các mức độ khác nhau, cổ phiếu công nghệ (AAPL) cho đỉnh nhọn nhất, cổ phiếu năng lượng (XOM) ít nhọn nhất nhưng rất lệch trái, cổ phiếu y tế (JNJ) bám sát lý thuyết nhất. Điều này cảnh báo các nhà đầu tư rằng: thị trường thực tế luôn có rủi ro mà các mô hình toán học không thể bao quát hết được. Nếu chỉ dựa vào lý thuyết để quản trị rủi ro, họ sẽ đánh giá thấp khả năng xảy ra các sự kiện sụp đổ hoặc tăng trưởng đột biến.
Vì sao Quant vẫn dùng GBM dù nó “sai”? Vì mọi mô hình đều là một phiên bản đơn giản hóa có chủ đích. Cái chúng ta cần không phải là một mô hình hoàn hảo, mà là một mô hình đủ tốt, có công thức tường minh, và cho phép định lượng được sai số của chính nó.
1.4. Kiểm chứng với Excel/VBA
Nếu bạn muốn tự tay kiểm tra lại bằng công thức thay vì code, file Excel bên dưới đã dựng sẵn Histogram.
Trong Excel, để tính Skewness, Kurtosis ta chỉ cần gọi trực tiếp hàm SKEW() và KURT(). Kiểm định Jarque-Bera phức tạp hơn, nhưng ta có thể tính theo công thức $JB = \frac{n}{6} \left( S^2 + \frac{1}{4}(K)^2 \right)$ trong đó $n$ là số lượng mẫu, $S$ là Skewness, $K$ là Excess Kurtosis; và dựa vào giá trị này để đưa ra kết luận.
2. Calibration: Hiệu chuẩn
Hiệu chuẩn là việc nhìn vào dữ liệu quá khứ để tìm ra bộ tham số cốt lõi mô tả mô hình. Hãy tưởng tượng mỗi cổ phiếu là một vận động viên chạy marathon. Để dự đoán vận động viên đó sẽ chạy được bao xa trong tương lai, bạn cần biết tốc độ trung bình và nhịp thở/độ bền của họ dựa trên các cuộc đua trước đó. Trong mô hình GBM, chúng ta cần tìm:.
- Drift ($\mu$) xu hướng tăng trưởng trung bình kỳ vọng của cổ phiếu. Nếu $\mu$ dương, giá cổ phiếu có xu hướng tăng trong dài hạn và ngược lại.
- Volatility ($\sigma$) biên độ rung lắc, thước đo rủi ro. Nếu $\sigma$ càng cao, các đường mô phỏng sẽ càng zic-zac và lan tỏa rộng, thể hiện sự bất ổn của thị trường.
2.1. Phương pháp hiệu chuẩn
Trong bài toán này, chúng ta có hai hướng tiếp cận chính để tìm ra $\mu$ và $\sigma$. Một bên dựa trên tư duy tài chính thực dụng, một bên dựa trên nền tảng thống kê khắt khe.
Phương pháp tài chính là cách tiếp cận phổ biến nhất vì nó trực quan, dễ hiểu và dễ thực hiện. Các con số $\mu, \sigma$ đầu ra khớp với những gì nhà đầu tư nhìn thấy trên các trang tin chứng khoán như Bloomberg hay Reuters. Các bước thực hiện như sau:
- Tính lợi nhuận hàng ngày: $r_i = S_i - S_{i-1}$ hoặc $r_i = \ln(S_i / S_{i-1})$.
- Tính trung bình mẫu ($\bar{r}$), và độ lệch chuẩn mẫu ($s$).
- Annualization: Dữ liệu vừa tính theo ngày, nhưng các tham số mô hình thường mặc định theo năm. Để chuyển đổi, chúng ta cần một chút thủ thuật toán học (252 ngày giao dịch trong một năm):
Uớc lượng hợp lý tối đa là một phương pháp thống kê nhằm tìm ra các tham số sao cho xác suất xảy ra dữ liệu đã quan sát được là cao nhất. Các bước thực hiện như sau:
- Thiết lập hàm Log-Likelihood: Chúng ta xây dựng một hàm toán học dựa trên hàm mật độ xác suất của phân phối chuẩn cho toàn bộ chuỗi dữ liệu.
- Tối ưu hóa: Bằng cách lấy đạo hàm và giải phương trình, MLE đưa ra các ước lượng không chệch nhất về mặt toán học.


Bạn hãy tưởng tượng bạn có dữ liệu giá chứng khoán với phân phối thực tế như một dải núi nhấp nhô. Bạn biết dải núi đó gần với hình chuông, nhưng bạn không biết cái chuông này nên rộng bao nhiêu và nằm ở đâu. Tham số $\mu$ điều chỉnh cái chuông sang trái hoặc sang phải. Tham số $\sigma$ điều chỉnh cái chuông béo ra hoặc gầy lại. MLE chính là quá trình bạn thay đổi $\mu$ và $\sigma$ sao cho hình chuông lý thuyết khớp nhất với dữ liệu thực tế bạn đang có (Hình 5).
2.2. Hiệu chuẩn với Python
Hàm data.mean() và data.std() là cách tiếp cận số học đơn giản mà chúng ta đã học ở trường với mean() để tính trung bình và std() để tính độ lệch chuẩn mẫu. Hàm stats.norm.fit(data) chính là nơi phép màu MLE xảy ra. Hàm này sẽ tự động điều chỉnh để tìm ra $\mu$ và $\sigma$ sao cho đường cong lý thuyết khớp nhất với biểu đồ thực tế của bạn.
# --- 5. Calibrattion ---
# --- Financial Approach ---
mean_annual = log_returns.mean() * 252
std_annual = log_returns.std() * np.sqrt(252)

# ---  MLE Approach ---
mu, sigma = stats.norm.fit(log_returns)
mu_annual = mu * 252
sigma_annual = sigma * np.sqrt(252)
--- AAPL (Lognormal Fit) ---
                    Metric  Financial       MLE
         Annual Drift (mu)   0.174843  0.174843
 Annual Volatility (sigma)   0.276458  0.276182
Kết quả cho thấy sự tương đồng rất lớn giữa phương pháp tài chính và MLE. Với $\mu$ đạt mức 17.48% và $\sigma$ khoảng 27.62%, chúng ta đã có một bộ tham số đáng tin cậy là nguyên liệu đầu vào cho các ứng dụng ở Phần 3.
2.3. Hiệu chuẩn với Excel/VBA
Với phương pháp tài chính, để tính $\mu$, $\sigma$ ta chỉ cần gọi trực tiếp hàm AVERAGE() và STDEV.S() trong Excel. Đây chính là trung bình và độ lệch chuẩn mẫu theo ngày, ta cần chuyển về đơn vị theo năm.
Với phương pháp MLE yêu cầu chạy tính toán nhiều lần để tìm ra bộ tham số tối ưu. Trong Excel có công cụ Solver có thể làm điều này với một quá trình thử và sai có hệ thống. Để chạy Solver:
- Vào thẻ Data > Solver (nếu chưa có, bạn cần kích hoạt trong File > Options > Add-ins).
- Set Objective: Chọn ô
$L$6(chứa Log-Likelihood tính sẵn); To : Chọn Max. - By Changing Variable Cells: Chọn vùng
$IK$4:$K$5(chứa $\mu$ và $\sigma$ dự đoán). - Constraints: Nhấn Add thêm điều kiện
$K$5 >= 0.0001(vì biến động không thể bằng $0$ hoặc âm). - Nhấn Solve.
Cả hai phương pháp cho ta kết quả ước lượng $\mu$, $\sigma$ gần như giống hệt với phần Python.
3. Ứng dụng thực tế của GBM
Có bộ tham số hiệu chuẩn rồi, ta sẽ dùng nó để làm gì? Phần 3 trình bày những ứng dụng thông dụng nhất của GBM trong công việc Quant thực tế.
3.1. Dự báo kịch bản tương lai
Một hiểu lầm phổ biến là Quant dùng GBM để dự báo giá cổ phiếu trong tương lai, từ đó tìm kiếm cơ hội giao dịch mang lại lợi nhuận. Trong thực tế, GBM không có khả năng để làm việc này. Lý do rất đơn giản đến từ giả thuyết thị trường hiệu quả: nếu giá cổ phiếu dễ dàng dự báo được chỉ bằng một phương trình vi phân ngẫu nhiên đơn giản, cơ hội kinh doanh chênh lệch giá sẽ lập tức biến mất.
Mục đích ở đây không phải là đoán xem giá AAPL ngày mai là bao nhiêu, mà là xây dựng một mô hình cơ sở để đo lường sự phân tán của rủi ro dựa trên biến động. Ta không biết chính xác giá AAPL thực tế sẽ đi đường nào, nhưng mô hình cho ta tất cả những con đường khả thi mà AAPL có thể đi qua. Kết quả có được không chỉ là một giá mục tiêu, mà là một phễu xác suất giúp nhận biết vùng giá nào dễ xảy ra nhất.
Ta sử dụng công thức tính giá (4.7) như trong Bài 4. Brownian Motion, nhưng chú ý ở đây ta mô phỏng toàn bộ đường đi của giá cổ phiếu chứ không chỉ một điểm cuối cùng. Công thức được viết lại như sau với bước thời gian là $\Delta t$ (1 ngày) thay vì cả khoảng thời gian $T$.
\[S_{t + \Delta t} = S_t \exp\!\left[\left(\mu - \frac{\sigma^2}{2}\right)\Delta t + \sigma \Delta W_t \right] \tag{5.2}\]# --- 6 Simulation Parameters ---
S_initial = df_prices['close'].iloc[-1]
dt = 1 / 252 # Time step (1 day)
n_steps = 90 # 90 trading days
n_simulations = 10000 # 10000 scenarios
# --- 7. Projection Random Paths ---
np.random.seed(42)
dW_t = np.random.normal(loc=0, scale=np.sqrt(dt), size=(n_steps, n_simulations))
daily_growth = np.exp((mu_annual - 0.5 * sigma_annual**2) * dt + sigma_annual * dW_t)
simulated_paths = S_initial * np.cumprod(daily_growth, axis=0)
simulated_paths = np.vstack([np.full(n_simulations, S_initial), simulated_paths])
Bây giờ ta thử vẽ 100 kịch bản đường đi ngẫu nhiên, cùng khoảng tin cậy 90%. Giá quá khứ history_window = 90 ngày trước cũng được thêm vào để giúp ta có cái nhìn trực quan nhất.
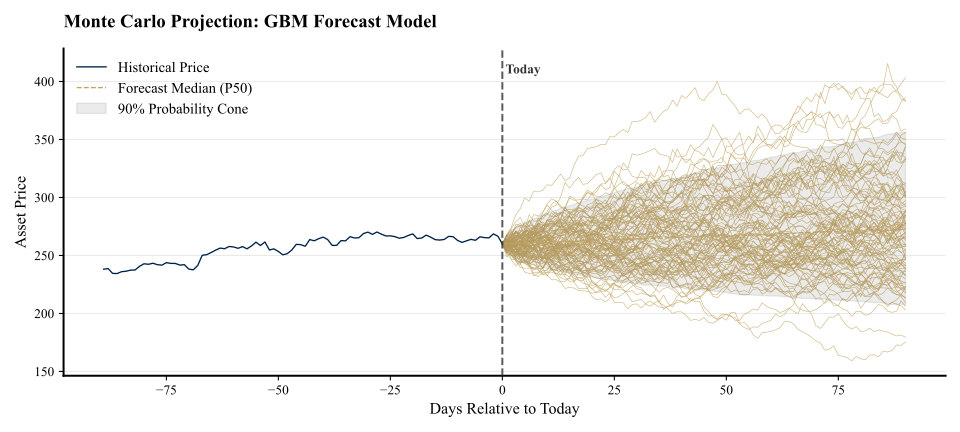
Biểu đồ phía trên là một bức tranh toàn cảnh về cổ phiếu APPL: từ thực tế trần trụi quá khứ (đường màu xanh) đến một tương lai đầy biến động qua các kịch bản mô phỏng (những đường màu vàng).
- Vùng tô màu xám nhạt chính là nơi mà mô hình tin rằng giá cổ phiếu Apple sẽ nằm trong đó với xác suất 90%. Bạn có thể thấy chiếc phễu này càng lúc càng loe rộng ra, phản ánh một quy luật tự nhiên trong tài chính: thời gian càng xa, sự bất định càng lớn.
- Hãy để ý có một vài đường màu vàng nằm hẳn ra ngoài vùng tô màu đậm. Đây chính là những kịch bản thiên nga đen. Dù GBM có xu hướng đánh giá thấp rủi ro so với thực tế, nó vẫn cho ta cái nhìn trực quan về biên độ rủi ro tiềm năng.
Tóm lại, bước mô phỏng này không cung cấp một “con số dự báo”, mà tạo ra dữ liệu đầu vào cho các bài toán định giá phái sinh hoặc tính toán rủi ro ở các phần tiếp theo.
3.2. Quản trị rủi ro: Value-at-Risk và Expected Shortfall
Câu hỏi của một nhà quản trị rủi ro không phải là “giá tăng hay giảm bao nhiêu?”, mà là “trong kịch bản xấu, tôi có thể tổn thất tối đa bao nhiêu với một độ tin cậy cho trước?”. Hai công cụ quản trị rủi ro kinh điển dưới đây sẽ cho ta câu trả lời.
Value-at-Risk (VaR) cho biết mức thua lỗ tối đa mà một vị thế có thể gặp phải trong một khoảng thời gian nhất định, với một độ tin cậy cho trước (thường là 95% hoặc 99%). Khai báo lỗ $L = S_0 - S_T$ ($L > 0$ là lỗ) bằng giá ban đầu ($S_0$) trừ đi giá ở thời điểm cuối ($S_T$). VaR 95% được xác định như sau:
\[\text{VaR}_{95\%} = \text{percentile}_{95\%}(S_0 - S_T) \tag{5.3}\]Ý nghĩa là trong 95% điều kiện thị trường bình thường, mức lỗ của bạn sẽ không vượt quá con số này. Hạn chế lớn nhất của chỉ số này là không cho biết mức độ nghiêm trọng ở phần đuôi phân phối. VaR chỉ đóng vai trò như một ngưỡng lỗ xấu, mà không quan tâm nếu rơi vào kịch bản xấu đó, bạn lỗ 100% hay 200%.
Expected Shortfall (ES), hay còn gọi là CVaR khắc phục nhược điểm này bằng cách lấy trung bình mức lỗ trong kịch bản xấu nhất (khi rủi ro đã vượt quá ngưỡng VaR):
\[\text{ES}_{95\%} = \mathbb{E}\big[S_0 - S_T \;\big|\; S_0 - S_T \geq \text{VaR}_{95\%}\big] \tag{5.4}\]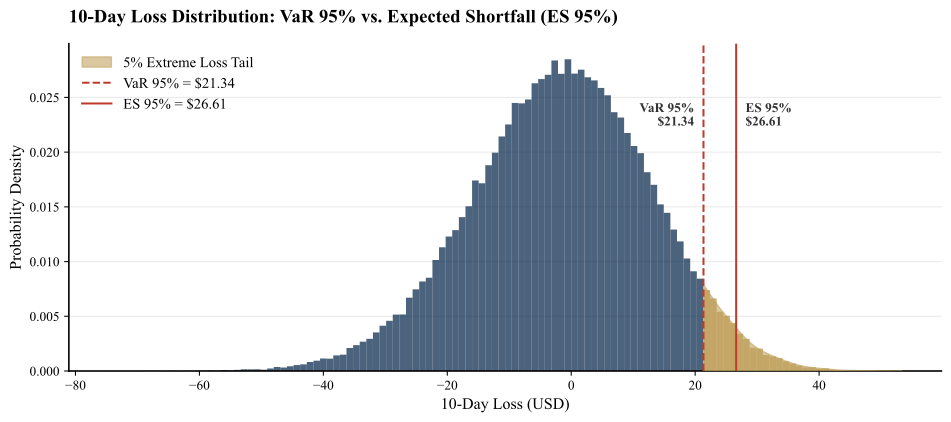
Lưu ý ở Phần 3.1, ta mô phỏng phễu xác suất cho 90 ngày nhằm mục đích hình dung bức tranh dài hạn. Tuy nhiên, trong quản trị rủi ro, các quy định pháp lý và thực tế vận hành ngân hàng thường quy định khoảng rủi ro ngắn hơn nhiều: 1 ngày đến 10 ngày giao dịch. Do đó, để tính VaR và ES cho 10 ngày, ta sẽ chạy lại mô phỏng với n_steps = 10 và tăng số lượng kịch bản lên 100000 để kết quả chính xác hơn.
loss = S_initial - simulated_paths[-1]
VaR95 = np.percentile(loss, 95)
ES95  = loss[loss >= VaR95].mean()
VaR95 (10 days) = 21.34 USD (8.21% position)
ES95  (10 days) = 26.61 USD (10.24% position)
Đọc con số này thế nào? Với độ tin cậy 95%, bạn kỳ vọng không mất quá 21.34 USD trên mỗi cổ phiếu AAPL đang nắm giữ trong 10 ngày tới. Nhưng nếu rơi vào nhóm 5% kịch bản xấu nhất, mức lỗ trung bình trong nhóm là 26.61 USD – đây chính là con số mà bộ phận quản trị rủi ro thường báo cáo lên cấp quản lý.
3.3. Định giá phái sinh
Ứng dụng kinh điển nhất của GBM trong tài chính định lượng không phải là quản trị rủi ro, mà là định giá phái sinh. Thay vì đi tìm một công thức giải tích phức tạp, ta có thể dùng mô phỏng Monte Carlo dựa trên GBM để định giá hầu như mọi loại quyền chọn từ cơ bản đến phức tạp. Chi tiết sẽ được trình bày trong series về phương pháp Monte Carlo, bắt đầu từ Bài 10. Monte Carlo.
4. Quant Analyst vs. Quant Risk: Sự đối lập về triết lý mô hình
Cùng một mô hình nhưng cách sử dụng thực tế, cách thiết lập tham số đầu vào lại có sự khác biệt rất lớn. Qua đây ta cũng nhận thấy hai cách tư duy hoàn toàn trái ngược của Quant Analyst và Quant Risk.
Quant Analyst (QA) sống trong thế giới lý tưởng của độ đo trung hòa rủi ro ($\mathbb{Q}$-measure). Nhiệm vụ của họ là tìm ra giá trị hợp lý cho các sản phẩm tài chính với giả định “rủi ro đã bị loại bỏ hoàn toàn”. Trong thế giới này, các tham số được ước lượng từ dữ liệu lịch sử không có nhiều ý nghĩa mà cần dựa trên kỳ vọng của nhà đầu tư về tương lai: $\mu$ được thay bằng lãi suất phi rủi ro $r$, còn $\sigma$ dựa trên implied volatility từ thị trường. Với họ, GBM là cỗ máy quy đổi các dòng tiền rủi ro trong tương lai thành một mức giá chính xác ở hiện tại.
Ngược lại, Quant Risk (QR) bắt buộc phải đối mặt với độ đo thực ($\mathbb{P}$-measure). Họ không thể dựa vào giả định “rủi ro đã được phòng ngừa hoàn toàn”, bởi trên thực tế thanh khoản có thể đóng băng và sai số phòng ngừa luôn tồn tại. Tham số của mô hình được ước lượng từ dữ liệu lịch sử, và dùng để đo lường rủi ro. Họ không quan tâm đến mức giá trung bình hôm nay, mà soi chiếu vào phần đuôi của phân phối tổn thất để tính toán mức độ thiệt hại trong kịch bản thảm họa thông qua các chỉ số như VaR hay ES.
Tóm lại, nếu QA là người thiết kế chiếc xe đua F1 – tối ưu hóa tốc độ và đường đua lý tưởng dưới giả định mọi hệ thống vận hành hoàn hảo, thì QR chính là kỹ sư kiểm định phanh và túi khí – kẻ luôn hoài nghi mô hình và đo lường lực va đập nếu chiếc xe lao khỏi đường ray. QA dùng GBM dưới $\mathbb{Q}$ để định giá hợp đồng trong điều kiện rủi ro đã được phòng ngừa, còn QR dùng GBM dưới $\mathbb{P}$ để đo lường thiệt hại nếu mọi hàng rào phòng ngừa đều thất bại.
5. Tóm tắt và thảo luận
GBM đóng vai trò như một tiêu chuẩn vàng trong tài chính định lượng: vừa là nền tảng toán học nhập môn, vừa là chiếc cầu nối đưa ta từ lý thuyết xác suất thuần túy sang các bài toán thực tế phức tạp.
-
GBM không đúng, nhưng hữu ích. Kiểm định thực nghiệm cho thấy: lợi suất thực tế không tuân theo phân phối chuẩn mà có đuôi béo và đỉnh nhọn. Nhưng một mô hình đơn giản, có công thức tường minh, và đo lường được sai số của chính nó vẫn hữu ích hơn nhiều so với việc không có mô hình nào.
-
Hiệu chuẩn là cầu nối duy nhất giữa lý thuyết và dữ liệu thật. Việc lựa chọn dữ liệu và phương pháp ước lượng tham số ($\mu, \sigma$) quyết định sự sống còn của mô hình. Một mô hình đơn giản được hiệu chuẩn chuẩn xác vẫn mang lại giá trị vận hành cao hơn một mô hình phức tạp nhưng bị chệch tham số.
-
Dự báo kịch bản tương lai, quản trị rủi ro, hay định giá phái sinh đều xuất phát từ một mô hình duy nhất. Khác biệt ở đây là bạn dùng tham số đầu vào như nào, xử lý tập kịch bản mô phỏng đầu ra ra sao: “giá sẽ ở đâu?”, “tôi có thể mất bao nhiêu?”, hay “giá nào là hợp lý khi rủi ro đã bị loại bỏ hoàn toàn?”.
-
Thực hành Python
market_data.zip -
Thực hành Excel
 Excel Workbook
Hiểu rõ những hạn chế của GBM chính là bước đầu tiên để bạn trở thành một nhà đầu tư thận trọng và thông minh hơn.